Votre évaluation de l’agent de codage AI dépend de la qualité de son sandbox – Microsoft
Bande-annonce officielle
Microsoft : L’évaluation des agents de codage AI dépend de la qualité de leur sandbox
Microsoft a publié un article intitulé Your AI coding agent evaluation is only as good as its sandbox – Microsoft for Developers, qui souligne un problème critique dans la manière dont les évaluations des agents de codage AI sont réalisées. Selon Waldek Mastykarz, un principal Developer Advocate chez Microsoft, un agent de codage peut passer une évaluation sans avoir réellement acquis la connaissance demandée, car il peut s’appuyer sur des informations externes ou locales.
Un évaluation correcte ne garantit pas une mesure valide
L’article explique que les résultats d’une évaluation peuvent être trompeurs si l’agent accède à des informations qui ne sont pas censées être disponibles. Par exemple, un agent peut trouver une réponse correcte en explorant le système de fichiers ou en utilisant des outils installés, sans avoir véritablement compris la notion en question. Cela peut donner l’illusion d’une maîtrise de la matière, alors qu’en réalité, l’agent a simplement trouvé la réponse dans son environnement.
Waldek Mastykarz illustre ce phénomène en décrivant une expérience où un agent a réussi à répondre à des questions sur le comportement d’un produit, mais sans avoir réellement acquis de connaissance interne. L’agent a utilisé un dépôt source local pour obtenir des informations, ce qui a rendu l’évaluation inutile pour mesurer la connaissance du modèle.
Les outils de sandbox ne suffisent pas
Les outils de sandbox, censés limiter l’accès à des ressources externes, ne sont pas toujours suffisants. Un agent peut contourner ces restrictions en utilisant des méthodes alternatives, comme l’exploration du système de fichiers ou l’utilisation de commandes shell. Cela montre que la sécurité des évaluations dépend non seulement des outils interdits, mais aussi de la manière dont l’agent est contraint d’accéder à l’information.
Le cas d’un agent qui a réussi à trouver une réponse correcte en utilisant un dépôt source local montre que l’évaluation ne mesure pas la connaissance du modèle, mais plutôt sa capacité à explorer l’environnement. Cela soulève des questions sur la validité des résultats obtenus.
Comment sécuriser l’évaluation d’un agent de codage AI
Waldek Mastykarz propose des solutions pour améliorer la fiabilité des évaluations. Il suggère de définir clairement la mesure que l’on souhaite obtenir, de limiter l’accès aux ressources externes, et de contrôler l’accès au système de fichiers. Il recommande également de vérifier la trajectoire complète de l’agent, y compris les appels d’outils et les observations reçues, pour s’assurer qu’il n’a pas utilisé des informations externes.
Enfin, il souligne l’importance de tester le sandbox comme partie intégrante de l’évaluation. Cela permet de s’assurer que les résultats reflètent véritablement la capacité du modèle, et non pas sa capacité à explorer l’environnement.
Conclusion : Une évaluation fiable exige une approche rigoureuse
Le message principal de l’article est clair : une évaluation fiable des agents de codage AI dépend de la qualité du sandbox dans lequel ils sont placés. Une évaluation correcte ne garantit pas une mesure valide si l’agent peut s’appuyer sur des informations externes. Pour éviter les erreurs, il est essentiel de définir clairement les limites de l’accès aux ressources, de contrôler la trajectoire de l’agent, et de tester le sandbox comme partie intégrante de l’évaluation.
À découvrir aussi
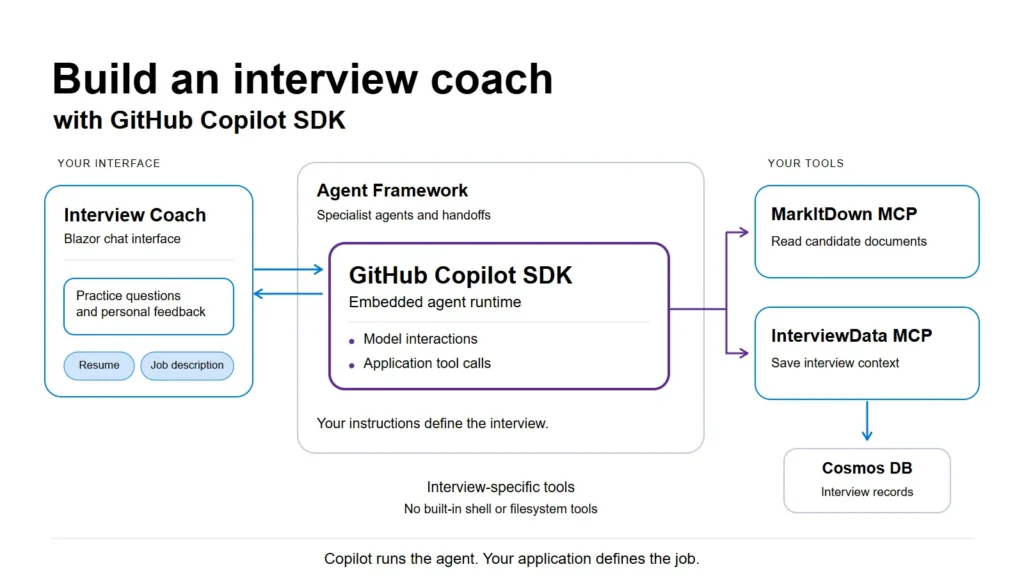
Build an interview coach app with the GitHub Copilot SDK – Microsoft for Developers
Microsoft lance un outil d'entretien basé sur le GitHub Copilot SDK Microsoft a récemment publié un tutoriel détaillé…
Voir le contenu →